经典机器学习17 章节
机器学习概览与通识
监督学习算法
端到端项目实战
核心导读
从用户—物品矩阵出发,手算相似度和预测评分,理解协同过滤、矩阵分解、召回排序、冷启动与离线评估。
1. 推荐系统究竟在预测什么?
推荐系统不是简单地“找热门内容”。它要在大量候选物品中,针对当前用户和上下文,选出有限位置展示的项目。目标可能是点击、播放、购买、停留时间或长期留存。
因此推荐系统通常分成三层:召回从百万级物品中快速找几百个候选;排序预测候选的相关性和业务价值;重排序处理多样性、库存、广告、频控和安全约束。
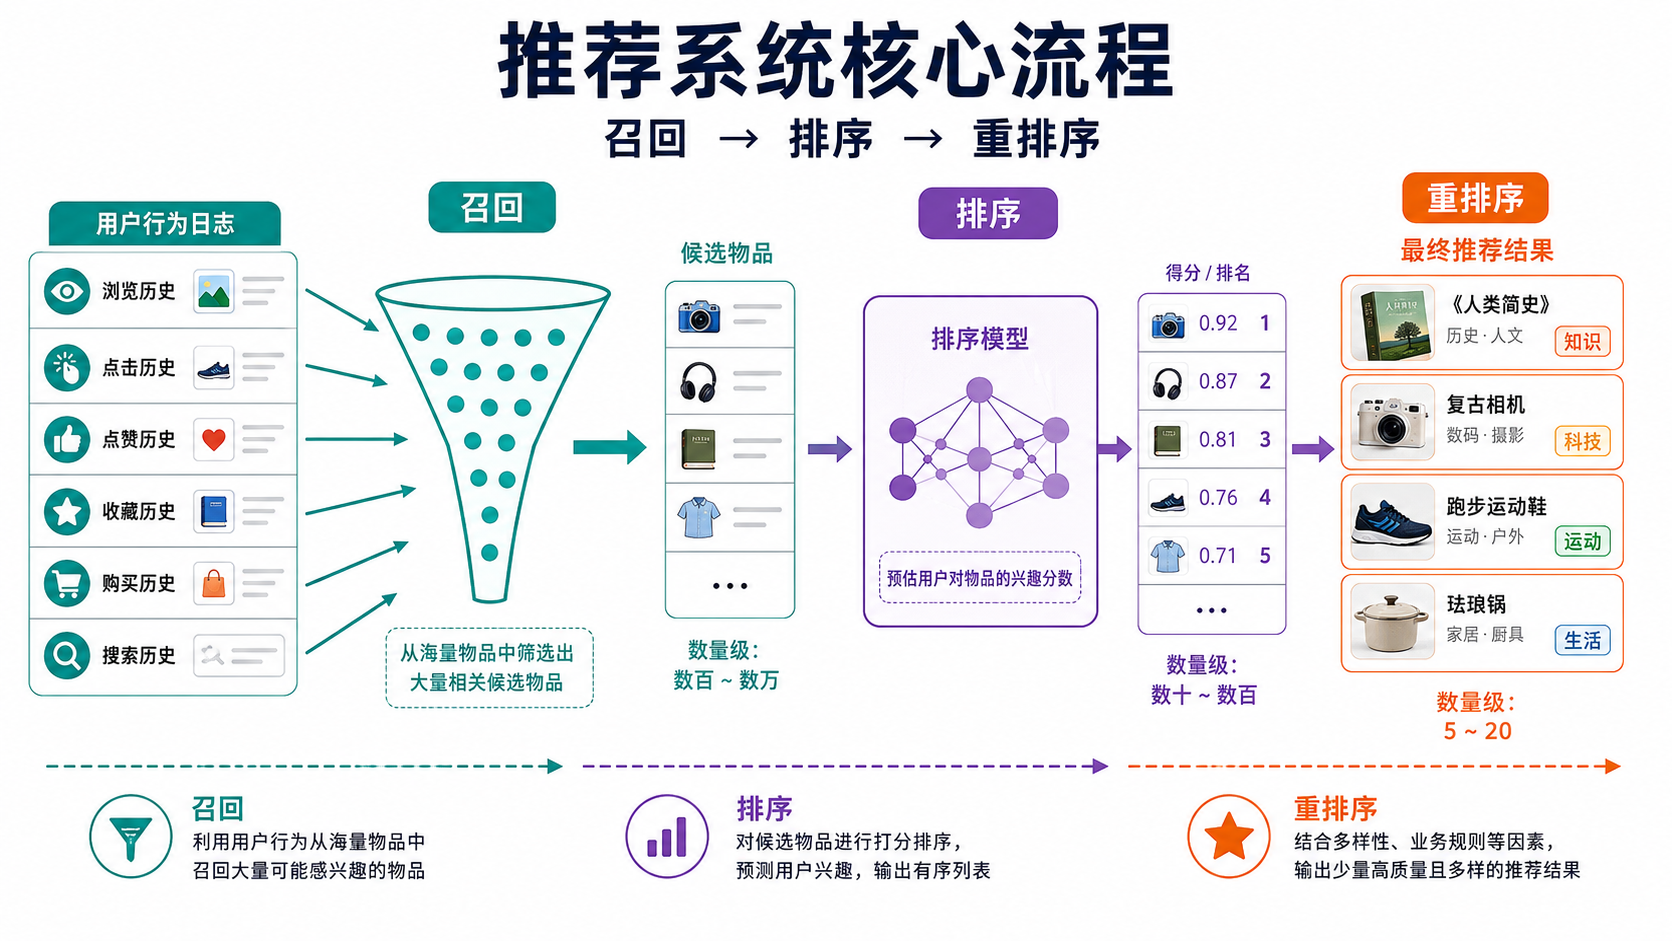 点击放大查看图:recommendation-pipeline
2. 学习目标
- 区分显式反馈和隐式反馈;
- 手算用户相似度、物品相似度和加权预测;
- 理解用户协同过滤与物品协同过滤;
- 推导交互矩阵 的含义;
- 理解召回、排序、重排序的工程边界;
- 使用时间切分与 Precision@K、Recall@K、NDCG 评估推荐;
- 识别冷启动、流行度偏置、曝光偏差和反馈闭环。
3. 反馈数据:没有交互不等于不喜欢
3.1 显式反馈
评分、喜欢/不喜欢、收藏等反馈直接表达偏好,但数量通常较少,且评分标准因用户而异。
3.2 隐式反馈
点击、浏览、播放完成、加购和购买数量大,但语义不唯一:用户可能因为标题吸引而点击,也可能因为误触;没有点击可能只是从未曝光。因此,交互矩阵中的 0 通常表示“未知”,不是负样本。
3.3 交互矩阵
令 表示用户 u 与物品 i 的交互:
矩阵非常稀疏。推荐的核心任务之一,就是利用已观察到的少数交互,估计未观察位置的偏好排序。
4. 手算案例一:用户协同过滤
假设用户 A 的评分为 ,用户 B 为 。只在二者共同评分的物品上比较:共同评分集合只有物品 1,因此直接使用相关系数不稳定。教学中常使用余弦相似度,并在足够共同物品时才采用结果:
若只看两个用户在物品 1、2、3 上的向量,设 A=(5,4,2),B=(4,3,1),则:
相似度接近 1,说明两人的评分方向接近。对 A 尚未评分的物品,可以寻找与 A 最相似的用户,并对他们给该物品的评分做加权平均:
实际系统通常还要减去用户平均分或加入用户偏置,否则“总体评分高的人”会被误认为与所有人相似。
4.1 完整预测手算:从相似用户到候选分数
假设用户 A 已看过物品 1、2,尚未看物品 3。系统找到两个相似用户:B 对物品 3 的评分为 2,C 的评分为 5;相似度分别为 0.8 和 0.6。加权预测为:
如果推荐阈值为 3,物品 3 会进入候选集。若用户 B、C 的平均评分不同,还应先做中心化:
中心化可以减少“某个用户习惯给高分”造成的偏差。
5. 手算案例二:物品协同过滤
物品协同过滤把每一列看成物品向量:如果喜欢物品 1 的人也经常喜欢物品 3,那么用户喜欢物品 1 时可以召回物品 3。
它的优势是物品相似度相对稳定、容易解释;缺点是新物品没有历史交互时无法被召回。电商“买了这个的人还买了”就是典型的物品协同过滤表达。
协同过滤矩阵实验室
选择用户,观察已交互物品与候选推荐。
| 用户 / 物品 | 电影 1 | 电影 2 | 电影 3 | 电影 4 |
|---|---|---|---|---|
| 用户 A | 5 | 4 | — | — |
| 用户 B | 4 | — | 2 | 1 |
| 用户 C | — | 5 | 4 | — |
| 用户 D | 1 | — | 5 | 4 |
5.1 相似度到底从哪里来?把“列”当作向量
行对应用户 1~4,列对应物品 1~4。取出第 1 列和第 3 列:
| 用户 | 对物品 1 的评分 | 对物品 3 的评分 |
|---|---|---|
| 用户 1 | 5 | 0 |
| 用户 2 | 4 | 2 |
| 用户 3 | 0 | 4 |
| 用户 4 | 1 | 5 |
因此,物品 1 的“被用户评分模式”是 ,物品 3 的模式是 。这两个向量的每一维都对应同一个用户,所以可以比较它们的夹角:
把数字代入:
这个 0.299 的含义不是“用户会以 29.9% 概率喜欢物品 3”,而是:在这份小矩阵里,两个物品的用户评分模式有一定同向性,但并不强。余弦相似度只衡量向量方向,范围通常在 ;评分、点击等非负数据中常落在 。
5.2 从相似度变成对用户的推荐分数
用户 1 已经接触过物品 1、2,评分分别是 5、4。对用户 1 尚未接触的物品 3,代码计算:
其中 ,所以:
对物品 4 同样计算一个分数,再按分数从高到低排序。这里的 score 是排序分数,不是校准后的评分预测;代码将已看过的物品分数设为负无穷,确保它们不会再次被推荐。
Tip
本例为了便于手算,把未评分位置暂时作为 0 参与余弦计算。真实显式评分系统通常只比较共同评分用户,并做均值中心化;隐式反馈系统则会使用加权、时间衰减、热门度惩罚等处理,避免“热门物品和所有物品都相似”。
6. 矩阵分解:学习隐向量
协同过滤可以进一步学习低维用户向量和物品向量:
其中 是用户隐向量, 是物品隐向量, 远小于原始物品数。预测分数是:
如果用户向量 ,电影 3 向量 ,则预测偏好:
向量每一维通常没有直接的人类标签,但其组合可以表示动作偏好、价格敏感度或内容风格等潜在因素。
6.1 只在观察到的交互上训练
显式评分的基础目标可以写成:
是已观察交互集合;不能把所有缺失值都当作 0,否则模型会被“用户从未见过”主导。隐式反馈系统通常给正交互更高权重,并从未交互中采样负例。
6.2 矩阵分解的一次梯度更新
假设已观察评分 ,当前用户向量 ,物品向量 ,预测值为:
误差 。忽略正则项,平方误差对用户向量的梯度为 ,对物品向量的梯度为 。学习率取 :
更新后 会更接近真实评分。实际训练还会加入 和 的正则梯度,并对大量已观察交互重复迭代。
7. Python 实战:物品相似度召回基线
用余弦相似度推荐相似物品
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics.pairwise import cosine_similarity
R = np.array([
[5, 4, 0, 0],
[4, 0, 2, 1],
[0, 5, 4, 0],
[1, 0, 5, 4],
], dtype=float)
# 列是物品,转置后计算物品之间的相似度
item_similarity = cosine_similarity(R.T)
user_id = 0
seen = set(np.where(R[user_id] > 0)[0])
scores = R[user_id] @ item_similarity
scores[list(seen)] = -np.inf # 不推荐已经看过的物品
recommended = np.argsort(scores)[::-1]
print("推荐物品索引:", recommended.tolist())
# 热力图能直观看出哪些物品向量相似;颜色越深,相似度越接近 1。
plt.figure(figsize=(5, 4))
plt.imshow(item_similarity, cmap="YlGnBu", vmin=0, vmax=1)
plt.colorbar(label="余弦相似度")
plt.xticks(range(R.shape[1]), [f"物品 {i}" for i in range(R.shape[1])])
plt.yticks(range(R.shape[1]), [f"物品 {i}" for i in range(R.shape[1])])
plt.title("物品—物品相似度矩阵")
for i in range(R.shape[1]):
for j in range(R.shape[1]):
plt.text(j, i, f"{item_similarity[i, j]:.2f}", ha="center", va="center", fontsize=9)
plt.tight_layout()
plt.show()
这个基线简单、可解释,适合先验证数据管道。真正上线前还要处理相似度收缩、热门度偏置、时间衰减和候选数量限制。
8. 召回、排序与重排序
8.1 召回
召回追求高覆盖和低延迟,可以并行使用热门召回、物品协同召回、向量近邻召回和规则召回,再合并去重。
8.2 排序
排序模型可以使用用户、物品、上下文和交叉特征,预测点击率、转化率或多目标效用。训练样本必须记录曝光,否则点击数据会严重偏向“已经被展示过”的物品。
8.3 重排序
即使相关性分数很高,也不能把同一作者或同一品类占满页面。重排序阶段加入多样性、新鲜度、库存、内容安全与频次约束。
9. 评估:为什么不能只看准确率?
9.1 时间切分
推荐系统预测未来行为,必须用过去训练、未来测试:例如用 1–8 月训练,用 9 月最后一次交互测试。随机切分会让未来信息泄漏到训练集。
9.2 Top-K 指标
对用户 u 的推荐列表 :
其中 是测试期真实发生的相关物品。NDCG@K 进一步给排名靠前的命中更高权重:同样命中 3 个物品,排在第 1、2、3 位通常比排在第 8、9、10 位更好。
9.3 Top-K 指标手算
某用户测试期真实喜欢的物品集合为 ,系统推荐前 5 个物品为 。命中的是 a、c,共 2 个:
若 a 排在第 2 位、c 排在第 4 位,则:
NDCG 还要除以把 3 个相关物品排在前 3 位时的理想 DCG,因此会同时惩罚“命中少”和“命中位置靠后”。
9.3 离线指标不是线上价值
离线数据反映历史曝光和历史策略。线上还要通过 A/B 测试观察点击、购买、留存、投诉、多样性和长尾覆盖;短期点击上升不一定带来长期用户价值。
9.4 时间切分代码
按时间构造最后一次交互测试集
events = events.sort_values(["user_id", "timestamp"])
test = events.groupby("user_id").tail(1)
train = events.drop(test.index)
# 训练只能使用 train;test 用于模拟每个用户未来的一次行为
print(train["timestamp"].max() <= test["timestamp"].min())
按用户留出最后一次交互能模拟“预测下一次行为”。如果一个用户只有一次交互,应将其放入冷启动评估或过滤掉,而不能同时出现在训练和测试中。
10. 冷启动与偏置
| 问题 | 表现 | 常见策略 |
|---|---|---|
| 新用户冷启动 | 没有历史交互 | 热门/内容问答/首屏探索 |
| 新物品冷启动 | 没有协同信号 | 内容特征、编辑规则、探索曝光 |
| 流行度偏置 | 热门物品越来越热门 | 长尾加权、探索与多样性 |
| 曝光偏差 | 只学习被展示过的物品 | 记录曝光、负采样、反事实校正 |
| 反馈闭环 | 推荐结果改变未来数据 | 保留探索流量,监控分布漂移 |
11. 常见错误排查
| 现象 | 可能原因 | 改进 |
|---|---|---|
| 推荐全是热门物品 | 目标只优化点击或相似度 | 加入多样性、长尾和新鲜度约束 |
| 离线指标很高,线上无提升 | 时间泄漏或曝光偏差 | 时间切分,记录真实曝光 |
| 新用户没有推荐 | 依赖历史协同信号 | 热门、内容和探索兜底 |
| 推荐重复看过的物品 | 未过滤已交互项目 | 召回/排序前过滤并保留业务例外 |
| 矩阵分解过拟合 | 向量维度太高、正则太弱 | 降低维度、增加正则、时间验证 |
12. 本节检查清单
- 我能区分显式反馈与隐式反馈。
- 我知道缺失交互不等于负反馈。
- 我能手算余弦相似度和一个隐向量点积。
- 我能解释用户协同与物品协同的差异。
- 我理解 和正则化目标。
- 我能区分召回、排序和重排序。
- 我会使用时间切分和 Top-K 指标。
- 我能识别冷启动、曝光偏差和反馈闭环。
13. 课程收束
无监督学习主线到此形成闭环:聚类发现群体,PCA 压缩表示,推荐系统利用用户—物品行为结构做个性化排序。后续可学习近邻检索、深度推荐、双塔模型和向量数据库。
14. 参考资料
本页目录
1. 推荐系统究竟在预测什么?
2. 学习目标
3. 反馈数据:没有交互不等于不喜欢
3.1 显式反馈
3.2 隐式反馈
3.3 交互矩阵
4. 手算案例一:用户协同过滤
4.1 完整预测手算:从相似用户到候选分数
5. 手算案例二:物品协同过滤
5.1 相似度到底从哪里来?把“列”当作向量
5.2 从相似度变成对用户的推荐分数
6. 矩阵分解:学习隐向量
6.1 只在观察到的交互上训练
6.2 矩阵分解的一次梯度更新
7. Python 实战:物品相似度召回基线
8. 召回、排序与重排序
8.1 召回
8.2 排序
8.3 重排序
9. 评估:为什么不能只看准确率?
9.1 时间切分
9.2 Top-K 指标
9.3 Top-K 指标手算
9.3 离线指标不是线上价值
9.4 时间切分代码
10. 冷启动与偏置
11. 常见错误排查
12. 本节检查清单
13. 课程收束
14. 参考资料