经典机器学习17 章节
机器学习概览与通识
监督学习算法
端到端项目实战
核心导读
从邻域密度出发,手算 DBSCAN 的核心点、边界点和噪声点,并理解层次聚类、树状图与算法选型。
1. 为什么需要密度聚类?
K-Means 假设每个簇大致是围绕质心的球,并且必须提前指定 K。当数据呈现月牙形、环形、长条形,或包含少量离群点时,质心会把一个连续的弯曲区域硬切开,也可能被离群点拉向错误方向。
密度聚类换一个问题:哪些点处在足够密集、彼此可达的区域? DBSCAN 不需要预先指定簇数,还能把低密度区域标记为噪声。
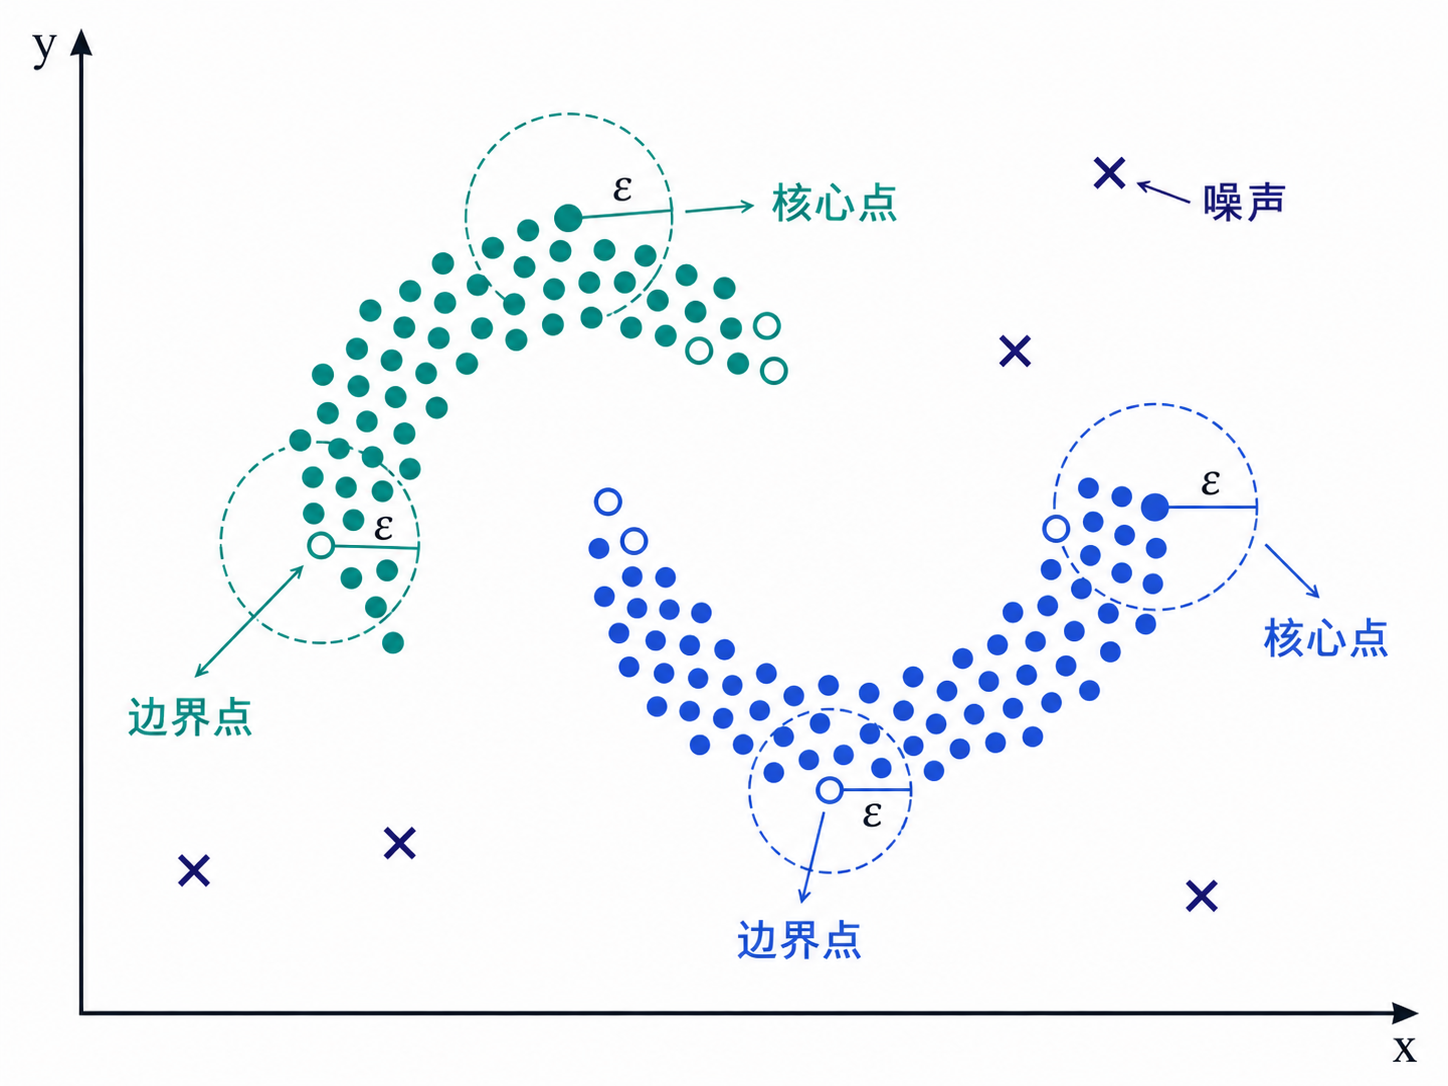 点击放大查看图:dbscan-density-intuition
2. 学习目标
- 理解 ε 邻域、核心点、边界点、噪声点与密度可达;
- 用一个小样例手算 DBSCAN 的标记过程;
- 掌握
eps、min_samples与特征缩放的关系; - 用 k-distance 图和领域知识选择参数;
- 理解凝聚层次聚类、linkage 与树状图切割;
- 根据形状、噪声、规模和解释需求选择聚类算法。
3. DBSCAN 的四个核心概念
设定两个参数:邻域半径 ε(eps)与最小样本数 min_samples。
3.1 ε 邻域
点 p 的 ε 邻域是所有满足 的点集合。scikit-learn 会把点 p 自己也算进邻域数量,因此 min_samples=4 表示半径 ε 内包含自己在内至少 4 个样本。
3.2 核心点、边界点与噪声点
若 ,p 是核心点,可以主动扩展簇。边界点本身邻域不够密,但落在某个核心点的 ε 邻域中,因此加入该簇。既不是核心点、也不在任何核心点邻域中的点就是噪声;在 scikit-learn 中标签为 -1。
DBSCAN 密度扩展实验室
点击样本查看 ε 邻域,调节参数观察核心点、边界点和噪声变化。
● 核心点● 边界点● 噪声
Tip
点击不同样本,先观察邻域数量,再调节 ε 和 min_samples。动画中的颜色只是当前参数下的判定,不是人工标签。
4. 手算样例:一步步运行 DBSCAN
考虑 8 个一维点,令 ε=1.5,min_samples=3(包含点自己)。一维距离只需做绝对值计算:。例如 A 到 C 的距离是 ,刚好等于 ε,所以 C 仍属于 A 的邻域。
| 点 | 坐标 | ε 邻域内的点 | 数量 | 自身是否核心 |
|---|---|---|---|---|
| A | 1.0 | A、B、C | 3 | 是 |
| B | 1.8 | A、B、C、D | 4 | 是 |
| C | 2.5 | A、B、C、D | 4 | 是 |
| D | 3.2 | B、C、D | 3 | 是 |
| E | 5.0 | E、F | 2 | 否 |
| F | 5.8 | E、F、G | 3 | 是 |
| G | 6.6 | F、G | 2 | 否 |
| H | 10.0 | H | 1 | 否 |
先不要把“不是核心点”等同于“噪声”。非核心点只有在所有点检查完后,才可能确定为边界点或噪声。下面按 DBSCAN 的实际扫描顺序手算。
第一步:从 A 展开簇 1
- 检查 A:A 的 ε 邻域为 A、B、C,数量是 3,满足
min_samples=3,所以 A 是核心点,创建簇 1。 - 将 A 的邻居 B、C 放入“待检查队列”。此时簇 1 暂记为 A、B、C。
- 检查 B:,所以 D 也在 B 的邻域中。B 是核心点,允许继续扩展,把 D 加入队列和簇 1。
- 检查 C:它同样是核心点,邻域仍为 A、B、C、D,没有新点。
- 检查 D:D 的 ε 邻域为 B、C、D,数量为 3,D 也是核心点;但它的邻居都已经在簇 1 中。
因此第一个簇完成:簇 1 包含 A、B、C、D。注意 A 不直接靠近 D(距离 2.2),但 A→B→D 是一条由核心点连接的路径,所以它们仍在同一簇。
第二步:理解“先是噪声候选,后来变边界点”
- 接着检查尚未归类的 E:E 的 ε 邻域为 E、F,只有 2 个点,不是核心点。此刻算法把 E 暂记为噪声候选,不会从 E 向外扩展。
- 再检查 F:F 的 ε 邻域为 E、F、G,数量为 3,F 是核心点,于是创建簇 2。
- F 的邻居 E、G 都被加入簇 2。虽然 E、G 自己的邻域数量都只有 2,不能继续向外扩展;但它们都在核心点 F 的 ε 邻域内,所以最终身份是边界点。
最终得到:簇 2 包含 E、F、G,其中 F 是核心点,E、G 是边界点。
第三步:处理 H
H 与最近的 G 的距离为 。它既不是核心点,也不落在任何核心点的邻域内,因此最终是噪声点。
最终标签可以写成:簇 1:A、B、C、D;簇 2:E、F、G;噪声:H。
这里的关键是“密度可达”:不要求簇内任意两点都直接相邻,只要求存在一条由核心点连接的路径。因此 DBSCAN 可以沿着弯曲的高密度带扩展,而 K-Means 做不到。
4.1 二维样例:从邻域圆到簇扩展
把点放回二维平面后,判断方法完全相同:以某点为圆心画半径 ε 的圆,圆内(包括圆周)样本数达到 min_samples,它就是核心点。
取 ε=1.1、min_samples=3,检查点 C=(2.6,2.0):
- 到 A=(1.2,1.5):,不在邻域;
- 到 B=(2.0,1.2):,在邻域;
- 到 D=(1.5,2.5):,不在邻域;
- C 自己也计数,因此当前邻域至少包含 B、C;若再有一个点落入圆内,C 就成为核心点。
这个计算说明:DBSCAN 的结果不是由“肉眼看起来接近”决定,而是由距离度量、ε 和计数规则共同决定。调大 ε 可能让 C 变成核心点,也可能让原本分离的两个簇连接起来。
5. DBSCAN 的算法流程
- 选择一个尚未访问的点 p。
- 查询 p 的 ε 邻域;若数量小于
min_samples,先标记为噪声候选。 - 若 p 是核心点,创建新簇,把其邻居放入队列。
- 逐个处理队列:遇到核心点就把它的邻域继续加入;遇到边界点只加入簇,不继续扩展。
- 所有点访问完毕后输出簇标签;噪声为
-1。
噪声候选并不一定最终是噪声:如果后来发现它在另一个核心点邻域内,它会被改为边界点。这是手算时容易漏掉的细节。
6. Python 实战:月牙形数据
比较 K-Means 与 DBSCAN
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import DBSCAN, KMeans
from sklearn.datasets import make_moons
from sklearn.preprocessing import StandardScaler
# 1. 生成两条弯月形二维样本;真实标签不参与任何聚类训练。
X, _ = make_moons(n_samples=300, noise=0.06, random_state=42)
# 2. 两种算法都使用距离,先统一两个坐标轴的尺度。
X = StandardScaler().fit_transform(X)
# 3. DBSCAN 不用指定簇数;eps 是邻域半径,min_samples 是核心点的最低邻域数量。
dbscan = DBSCAN(eps=0.28, min_samples=5)
db_labels = dbscan.fit_predict(X)
# 4. K-Means 必须预先指定 2 个簇,n_init=20 用于降低随机初始化的影响。
kmeans = KMeans(n_clusters=2, n_init=20, random_state=42)
km_labels = kmeans.fit_predict(X)
# -1 是 DBSCAN 标记的噪声点,不属于任何簇。
print("DBSCAN 标签:", sorted(set(db_labels)))
print("噪声点数量:", int(np.sum(db_labels == -1)))
print("K-Means 标签:", sorted(set(km_labels)))
# 5. 左图观察 K-Means 的切分,右图观察 DBSCAN 是否沿月牙密度带扩展。
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].scatter(X[:, 0], X[:, 1], c=km_labels, cmap="tab10", s=24)
axes[0].scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1],
c="black", marker="X", s=110, label="质心")
axes[0].set_title("K-Means:按质心切分")
axes[0].legend()
# 噪声点另外叠加黑色叉号,避免与普通簇的颜色混淆。
axes[1].scatter(X[:, 0], X[:, 1], c=db_labels, cmap="tab10", s=24)
axes[1].scatter(X[db_labels == -1, 0], X[db_labels == -1, 1],
c="black", marker="x", s=34, label="噪声")
axes[1].set_title("DBSCAN:按密度扩展")
axes[1].legend()
for ax in axes:
ax.set_xlabel("标准化特征 1")
ax.set_ylabel("标准化特征 2")
plt.tight_layout()
plt.show()
K-Means 会用一条近似直线切割月牙,而 DBSCAN 会沿两条月牙的密度结构找簇。make_moons 的真实标签只用于事后演示比较,DBSCAN 训练时没有使用它。
7. 参数选择与数据预处理:eps、min_samples 和距离
7.1 min_samples 定义“足够密”
值越小,稀疏区域越容易被认成簇,也更容易受噪声影响;值越大,需要更稳定、更密集的区域。可从特征维数 d 的 2–4 倍开始试验,但这只是起点。
7.2 k-distance 图寻找 eps
固定 ,对每个样本计算到第 k 个近邻的距离并排序。曲线突然变陡的位置,通常是密集点与稀疏噪声的分界,可作为 eps 候选:
计算 k-distance 曲线数据
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.neighbors import NearestNeighbors
from sklearn.preprocessing import StandardScaler
# 每个可运行代码块互不共享变量,因此重新生成示例数据。
X, _ = make_moons(n_samples=300, noise=0.06, random_state=42)
X = StandardScaler().fit_transform(X)
# 对每个样本,寻找第 min_samples 个最近邻的距离。
# 邻域计数包含样本自身,所以 n_neighbors 直接设为 min_samples。
min_samples = 5
neighbors = NearestNeighbors(n_neighbors=min_samples).fit(X)
distances, _ = neighbors.kneighbors(X)
# 每一行最后一个值是第 5 近邻距离;排序后可观察密度由高到低的变化。
k_distances = np.sort(distances[:, -1])
print("最大的 10 个第 5 近邻距离:", np.round(k_distances[-10:], 3))
# 曲线从平缓转为陡峭处是 eps 的候选范围,不是固定公式给出的唯一答案。
plt.figure(figsize=(7, 4))
plt.plot(k_distances, color="#0f766e", linewidth=2, label="第 5 近邻距离")
plt.axhline(0.28, color="#f59e0b", linestyle="--", label="示例 eps=0.28")
plt.xlabel("按距离排序后的样本序号")
plt.ylabel("第 5 近邻距离")
plt.title("k-distance 图:寻找 eps 的候选拐点")
plt.legend()
plt.tight_layout()
plt.show()
| 现象 | 可能原因 | 调整方向 |
|---|---|---|
| 几乎所有点都是噪声 | eps 太小或 min_samples 太大 | 增大 eps 或降低 min_samples |
| 几乎所有点合并为一簇 | eps 太大或 min_samples 太小 | 减小 eps 或提高 min_samples |
| 簇被切成很多碎片 | 局部密度不足 | 增大 eps,检查缩放 |
| 不同密度簇互相吞并 | 单一半径不适合 | 评估 HDBSCAN |
7.4 特征缩放、距离与工程边界
DBSCAN 的半径直接依赖距离单位。年龄(0–100)与年收入(0–1,000,000)若不缩放,同一个 ε 在两个方向代表完全不同的含义。应先使用 StandardScaler 或业务合理的归一化,再拟合 DBSCAN。
消费金额等长尾特征可先使用 log1p;缺失值必须先处理;异常值要先核验,不能无条件删除真实的高价值用户。地理坐标还要特别小心:经纬度不是平面米制坐标,小范围可投影到米制坐标,大范围应考虑 haversine 距离并把角度转为弧度。
8. 层次聚类:从单点逐步合并
层次聚类不先把数据压成一个固定 K,而是构造一棵从“每个样本一个簇”到“所有样本一个簇”的树。
10. 常见错误排查
| 现象 | 可能原因 | 改进方式 |
|---|---|---|
| 几乎所有点都是噪声 | eps 太小、min_samples 太大或特征未缩放 | 检查尺度,用 k-distance 图重新估计 eps |
| 几乎所有点合并为一簇 | eps 太大或 min_samples 太小 | 减小 eps,提高 min_samples,检查簇间距离 |
| 簇被切成很多碎片 | 局部密度不足或距离单位不合理 | 增大 eps,统一尺度,检查异常值 |
| 不同密度簇互相吞并 | DBSCAN 使用一个全局半径 | 评估 HDBSCAN 或分层建模 |
| 地理热点位置偏移 | 直接把经纬度当平面坐标 | 投影到米制坐标,或使用 haversine 距离 |
| 层次聚类结果对 linkage 很敏感 | linkage 改变了簇间距离定义 | 对比多种 linkage,并检查树状图与业务画像 |
11. 本节检查清单
- 我能用邻域数量判定核心点。
- 我能区分核心点、边界点和噪声点。
- 我能解释 DBSCAN 为什么可以识别月牙形簇。
- 我能手算一个小样例的簇扩展过程。
- 我会用缩放和 k-distance 图辅助选择
eps。 - 我能解释 single、complete、average、Ward 的差异。
- 我知道何时应该改用 HDBSCAN 或层次聚类。
- 我会结合稳定性、样本画像和业务规则验证聚类结果。
12. 下一步
继续学习主成分分析与降维,把高维特征压缩为更易计算、可视化和解释的表示。
13. 参考资料
本页目录
1. 为什么需要密度聚类?
2. 学习目标
3. DBSCAN 的四个核心概念
3.1 ε 邻域
3.2 核心点、边界点与噪声点
4. 手算样例:一步步运行 DBSCAN
第一步:从 A 展开簇 1
第二步:理解“先是噪声候选,后来变边界点”
第三步:处理 H
4.1 二维样例:从邻域圆到簇扩展
5. DBSCAN 的算法流程
6. Python 实战:月牙形数据
7. 参数选择与数据预处理:`eps`、`min_samples` 和距离
7.1 `min_samples` 定义“足够密”
7.2 k-distance 图寻找 `eps`
7.4 特征缩放、距离与工程边界
8. 层次聚类:从单点逐步合并
10. 常见错误排查
11. 本节检查清单
12. 下一步
13. 参考资料