经典机器学习17 章节
机器学习概览与通识
监督学习算法
端到端项目实战
核心导读
从几何投影到协方差矩阵和 SVD,手算 PCA 主成分,理解解释方差、重构误差和降维管道。
1. 为什么要降维?
一张用户表可能有数百个特征:浏览次数、购买次数、不同类别消费金额、设备信息和时间统计。特征越多,计算和存储成本越高,距离也越容易失去区分度;很多特征还在重复描述同一个潜在因素。
降维的目标不是随意删除列,而是寻找一个更小的坐标系,使样本在这个坐标系中保留尽可能多的有效变化。PCA 是最经典的线性降维方法。
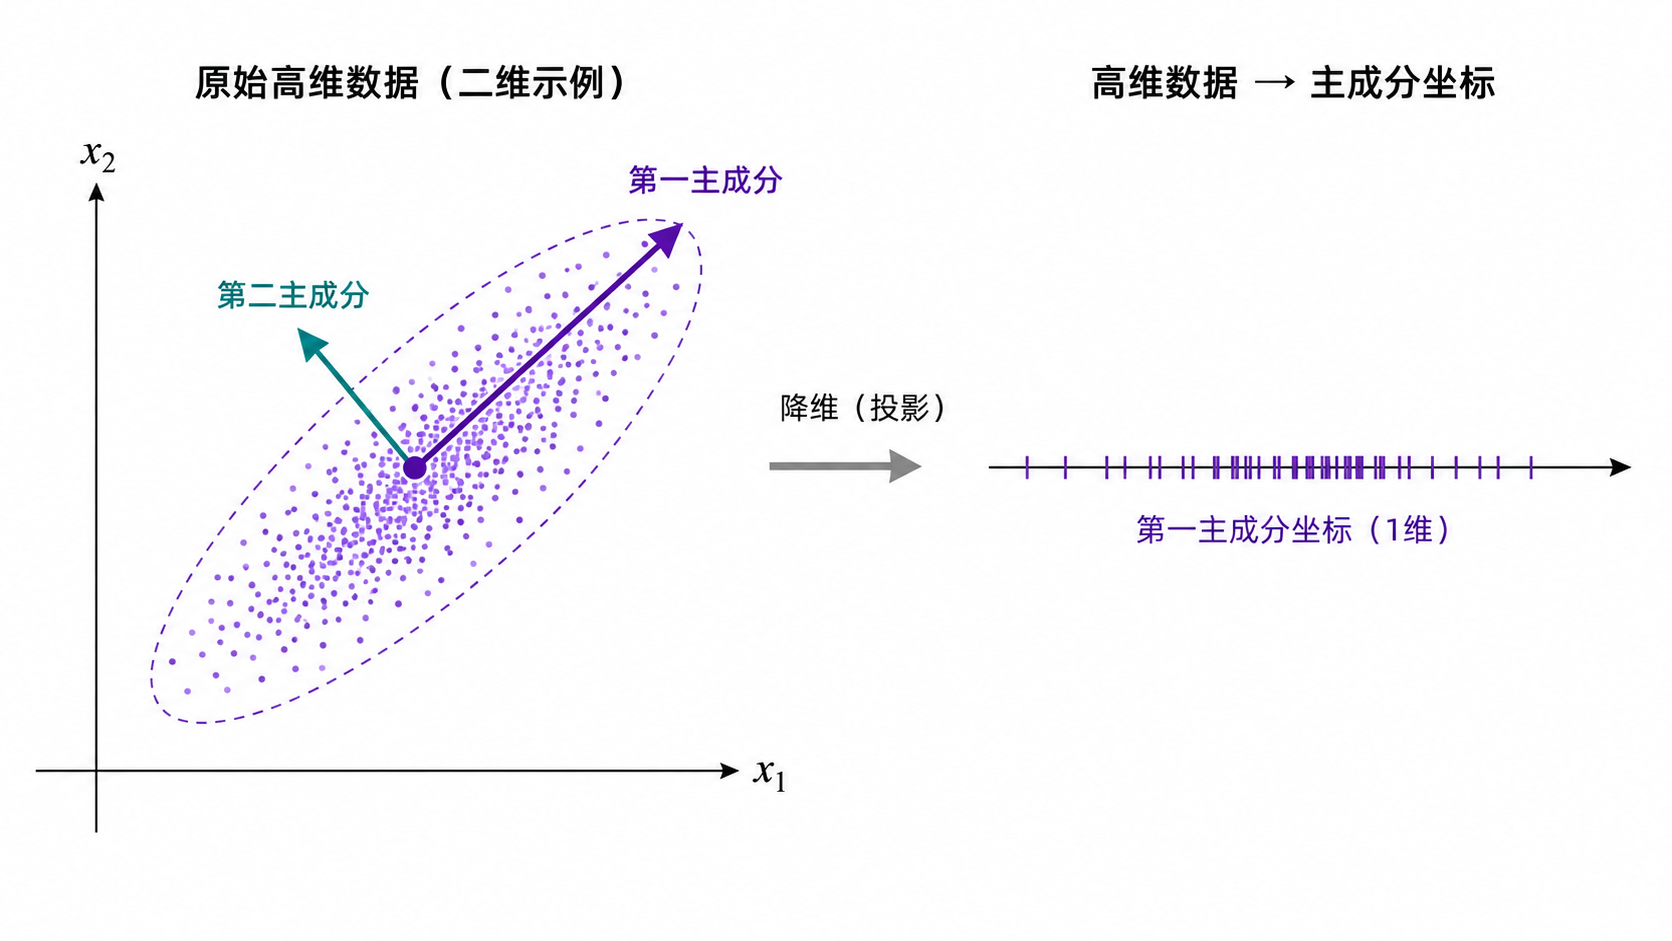 点击放大查看图:pca-projection-intuition
2. 学习目标
- 区分中心化、标准化和 PCA 投影;
- 用几何直觉解释“最大方差方向”;
- 手算一个二维数据集的协方差矩阵与第一主成分;
- 理解特征值、特征向量、SVD 与解释方差的关系;
- 根据累计解释方差选择保留维数;
- 使用
Pipeline防止 PCA 数据泄漏; - 判断 PCA、t-SNE、UMAP 各自适合什么问题。
3. PCA 的核心直觉
3.1 中心化:先把坐标原点移到数据中心
给定样本矩阵 ,先减去每一列的均值:
中心化后,数据云的中心位于原点。若不中心化,第一主成分可能只是指向“离原点最远”的方向,而不是描述样本自身的变化方向。
3.2 投影:用一个方向表示一个样本
取单位方向向量 ,样本 在该方向上的坐标为:
PCA 寻找让投影坐标方差最大的 :
这等价于寻找协方差矩阵最大特征值对应的特征向量。第一主成分解释变化最多;第二主成分必须与第一主成分正交,并在剩余方向中解释最多变化。
4. 手算样例:从协方差到主成分
取三个二维样本:、、。它们落在一条斜率为 1 的直线上。
4.1 中心化
均值为 ,因此:
4.2 计算协方差矩阵
使用总体协方差(除以 )便于手算:
矩阵的两个特征值为 、。对应的单位特征向量可以取:
第一方向沿数据最伸长的斜线;第二方向没有变化,因此不携带新的方差信息。
4.3 投影与重构
样本 中心化后为 ,投影坐标:
若只保留第一主成分,重构为:
因为样本本来就在第一主成分直线上,所以重构误差为 0。真实数据通常有噪声,丢弃较小特征值对应的方向就会产生一定重构误差。
4.4 非完美数据:重构误差从哪里来?
考虑三个不完全共线的样本:、、。它们大致沿右上方向,但点 偏离直线。PCA 仍会找到一条最大方差方向,但把样本压到一维后,垂直于该方向的信息会丢失。
设保留第一主成分后的投影为 ,重构为 。单个样本的平方重构误差是:
所有样本的平均重构误差可以写成:
保留更多主成分会让 不增,但也会降低压缩收益。实际选择维度,就是在信息损失和计算成本之间做权衡。
4.5 主成分符号为什么可能相反?
如果 是一个合法主成分,那么 也是合法主成分;所有投影坐标也会同时变号,重构结果不变。因此不同库、不同版本或不同运行可能显示相反的载荷符号,这不是模型错误。真正应比较的是方向、解释方差和重构结果,而不是单个符号。
5. 协方差、特征值与 SVD
对中心化矩阵 做 SVD:
- 的列向量是主成分方向;
- 奇异值平方与协方差矩阵特征值成正比;
- 是样本在主成分坐标系中的投影;
- 只保留前 个奇异值,就得到秩为 的最佳线性近似。
SVD 通常比手动构造协方差矩阵更稳定,尤其适合特征维数很高或矩阵接近奇异的情况。
5.1 解释方差比例
第 j 个主成分的解释方差比例为:
累计解释方差为前 r 个比例之和。它回答的是“保留 r 个方向后,原始总方差保留了多少”,不是“模型准确率保留了多少”。
6. 标准化与中心化不能混为一谈
- 中心化:每列减均值,PCA 的基本步骤;
- 标准化:再除以标准差,让量纲不同的特征具有可比尺度;
- 不标准化的 PCA:方差大的字段会主导主成分,只有在量纲本身有意义时才适合。
例如身高(厘米)和收入(元)放在一起时,通常需要 StandardScaler;而多个已经处于同一物理单位的传感器读数,是否标准化要依据测量意义判断。
7. Python 实战:解释方差与二维投影
训练 PCA 并选择保留维度
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.decomposition import PCA
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
wine = load_wine(as_frame=True)
X = wine.data
pipe = Pipeline([
("scaler", StandardScaler()),
("pca", PCA(n_components=0.90)), # 保留至少 90% 方差
])
Z = pipe.fit_transform(X)
pca = pipe.named_steps["pca"]
print("原始维度:", X.shape[1])
print("压缩维度:", Z.shape[1])
print("各主成分解释方差:", pca.explained_variance_ratio_)
print("累计解释方差:", pca.explained_variance_ratio_.cumsum())
# 左图用累计解释方差检查“保留 90%”具体需要几个主成分;虚线是目标阈值。
# 右图只取前两主成分作可视化,颜色是真实葡萄酒类别,仅用于事后观察分离度。
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
cum_var = pca.explained_variance_ratio_.cumsum()
axes[0].plot(range(1, len(cum_var) + 1), cum_var, marker="o", color="#0f766e")
axes[0].axhline(0.90, color="#f59e0b", linestyle="--", label="90% 阈值")
axes[0].set(xlabel="保留的主成分数", ylabel="累计解释方差", title="PCA 保留多少维?")
axes[0].legend()
# 单独拟合 2 维 PCA,只服务于平面展示,不改变上面的 90% 压缩模型。
Z2 = PCA(n_components=2).fit_transform(StandardScaler().fit_transform(X))
scatter = axes[1].scatter(Z2[:, 0], Z2[:, 1], c=wine.target, cmap="viridis", s=30)
axes[1].set(xlabel="主成分 1", ylabel="主成分 2", title="前两主成分投影")
fig.colorbar(scatter, ax=axes[1], label="真实类别(仅作观察)")
plt.tight_layout()
plt.show()
7.1 查看主成分载荷
pca.components_[j] 给出第 j 个主成分在原始特征上的权重。绝对值较大的载荷表示该特征对方向贡献更大;正负号表示方向,整体翻转主成分符号不会改变数学结果,因此不要把正负号当作绝对因果关系。
7.2 降维与后续模型的正确管道
应把 StandardScaler、PCA 和后续模型放在同一个 Pipeline 中,并在交叉验证的每个训练折内拟合:
PCA 与分类器组合
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score, StratifiedKFold
model = Pipeline([
("scaler", StandardScaler()),
("pca", PCA(n_components=0.95, random_state=42)),
("classifier", LogisticRegression(max_iter=2000)),
])
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
print(cross_val_score(model, wine.data, wine.target, cv=cv).mean())
7.3 降维前后比较下游任务
PCA 的目标是压缩方差,不保证分类准确率一定提高。可以用同一份交叉验证同时比较原始特征和 PCA 特征:
比较 PCA 前后的分类效果
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
raw_model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
pca_model = make_pipeline(
StandardScaler(), PCA(n_components=0.90), LogisticRegression(max_iter=2000)
)
raw_score = cross_val_score(raw_model, wine.data, wine.target, cv=cv).mean()
pca_score = cross_val_score(pca_model, wine.data, wine.target, cv=cv).mean()
print(f"原始特征: {raw_score:.3f}")
print(f"PCA 特征: {pca_score:.3f}")
如果 PCA 分数下降,不代表 PCA 错了:被压缩掉的低方差方向可能恰好包含标签信息。应同时报告压缩维数、解释方差、训练成本和任务指标。
8. PCA 的边界与替代方法
- PCA 是线性的,无法自然展开复杂曲面;
- 最大方差方向不一定是最能区分类别的方向;
- t-SNE 更强调局部邻域,适合探索性可视化,不宜解释全局距离;
- UMAP 兼顾局部结构与较好的全局布局,但参数和随机性仍需审查;
- 稀疏 PCA、核 PCA 和自编码器分别适合稀疏载荷、非线性结构和更复杂的表示学习。
9. 常见错误排查
| 现象 | 可能原因 | 改进 |
|---|---|---|
| 第一主成分几乎完全由一个字段决定 | 未标准化或存在极端尺度 | 检查量纲,比较标准化前后载荷 |
| 训练集效果很好,测试集下降 | 在切分前拟合了 scaler/PCA | 将预处理放进 Pipeline |
| 降维后可视化分得很开就认为分类一定好 | PCA 优化方差,不优化标签分离 | 用交叉验证评估下游任务 |
| 主成分含义难解释 | 原始特征高度相关或载荷分散 | 查看载荷、做特征分组或使用稀疏 PCA |
10. 本节检查清单
- 我能说明为什么 PCA 前通常要中心化。
- 我能手算均值、协方差矩阵和第一主成分。
- 我能解释特征值与解释方差的关系。
- 我知道标准化是否必要取决于特征量纲。
- 我会用累计解释方差选择维数。
- 我会用 Pipeline 防止 PCA 数据泄漏。
- 我能区分 PCA、t-SNE 和 UMAP 的用途。
11. 下一步
继续学习推荐系统基础:协同过滤与矩阵分解,把降维中的表示思想用于用户—物品行为数据。
12. 参考资料
本页目录
1. 为什么要降维?
2. 学习目标
3. PCA 的核心直觉
3.1 中心化:先把坐标原点移到数据中心
3.2 投影:用一个方向表示一个样本
4. 手算样例:从协方差到主成分
4.1 中心化
4.2 计算协方差矩阵
4.3 投影与重构
4.4 非完美数据:重构误差从哪里来?
4.5 主成分符号为什么可能相反?
5. 协方差、特征值与 SVD
5.1 解释方差比例
6. 标准化与中心化不能混为一谈
7. Python 实战:解释方差与二维投影
7.1 查看主成分载荷
7.2 降维与后续模型的正确管道
7.3 降维前后比较下游任务
8. PCA 的边界与替代方法
9. 常见错误排查
10. 本节检查清单
11. 下一步
12. 参考资料