准备知识12 章节
Python 与科学计算
核心导读
理解数据集中趋势(均值/中位数)与离散程度(方差/标准差),掌握正态分布钟形曲线与分类模型 Sigmoid 概率映射直觉。
1. 问题导入
为什么两组平均分都是 80 分的班级,实际的教学情况可能截然不同?
- A 班:每个人考分都在 78 ~ 82 分之间(成绩非常稳定整齐);
- B 班:一半人考了 100 分满分,另一半人考了 60 分(两极分化极度严重)。
单凭一个“平均分”不足以代表数据的全貌。现实世界充满了不确定性与数据波动。
概率统计赋予了人工智能“评估不确定性与数据分布”的能力:
- 集中趋势(均值、中位数):告诉我们数据的中心在哪里;
- 离散程度(方差、标准差):告诉我们数据的波动有多剧烈;
- 概率映射(Sigmoid):帮助机器学习模型将抽象的得分转化为直观的概率预测(如患病概率 92%)。
2. 学习目标
完成本章学习后,你将能够:
- 理解数据集中趋势指标(均值 Mean、中位数 Median)的区别与适用场景;
- 理解数据离散程度指标(方差 Variance、标准差 Standard Deviation)的物理直觉;
- 掌握正态分布 (Normal Distribution) 的对称“钟形曲线”特征与 经验法则;
- 理解 Sigmoid 函数将任意得分连续压缩映射为 概率值的物理直觉。
3. 概率的基本语言:事件、条件与更新
3.1 样本空间、事件与概率
概率论先研究随机试验的所有可能结果。掷一次硬币时,样本空间是 {正面, 反面};其中“出现正面”就是一个事件。若结果等可能,则正面的概率为:
概率始终满足三个基本事实:
- ;不可能事件的概率为 0,必然事件的概率为 1。
- 事件不发生的概率是补集:。
- 若两个事件不能同时发生,则 。
先画集合,再写概率
遇到概率题时,先用一句话说明“所有可能结果是什么”和“我关心哪个事件”。再决定分母应该数哪些情况。这个习惯比直接套公式更可靠。
3.2 条件概率与独立性
有时我们已经知道一部分信息。条件概率 表示:在事件 已发生的前提下,事件 发生的比例。
例如,从一副普通扑克牌中抽到一张牌,已知它是红色,再问它是红桃的概率;这时分母不再是全部 52 张,而是已知条件下的 26 张红牌。
两个事件若互不影响,称为独立事件,满足:
要注意:互斥和独立不是同一件事。两个互斥且概率不为零的事件不可能独立,因为一个发生会让另一个不发生。
3.3 贝叶斯公式:用条件概率反向计算
贝叶斯公式只是条件概率公式的重新整理:
它的数学意义是:已知 发生后,如何重新计算 的比例。阅读这条公式时,先找出事件 、条件 和分母 ;不要急着把它当成必须背诵的技巧。
3.4 随机变量与期望
随机变量不是一个“随机的未知数”,而是把随机试验结果映射成数值的规则。掷硬币时,可以规定正面记为 、反面记为 。若正反面等可能,则期望为:
期望是重复很多次试验后的长期平均,并不意味着单次试验一定会得到 。后续的均值、方差和分布,都是围绕随机变量的中心和波动展开的。
两道手算检查
- 掷一个公平骰子,写出样本空间,并计算“点数为偶数”的概率。
- 从装有 3 个红球、2 个蓝球的盒子中不放回抽两次。写出“第一次抽到红球”与“第二次抽到红球”的条件关系;思考为什么它们不是独立事件。
4. 数据的集中与离散:均值、中位数与方差
4.1 集中趋势:均值 vs 中位数
- 均值 (Mean, ):所有数据的算术平均数 。反映整体平均水平;
- 中位数 (Median):将数据从小到大排序后处于正中间的数字。
抗极端值对比(鲁棒性)
假设某小镇 5 户居民的年收入为 [10万, 12万, 11万, 13万, 1亿]:
- 均值:2096 万(受 1 亿富豪极值拉抬,严重偏离绝大多数普通人的生活感受);
- 中位数:12 万(不受极端富豪数据的影响,真实反映中等收入水平)。
结论:当数据中存在严重偏斜或极端异常值时,中位数比均值更有代表性。
4.2 离散程度:方差与标准差
为了衡量数据点围绕中心均值上下波动的剧烈程度,我们使用方差 (Variance) 和 标准差 (Standard Deviation)。
1. 方差计算公式
每个数据点与均值差值的平方和的平均数:
(注:之所以开平方,是为了防止“正负偏差相互抵消”,并放大较大误差)。
2. 标准差公式
因为方差的单位是原单位的平方,所以我们将方差开根号,得到与原数据单位一致的标准差 :
- 标准差小:数据点紧紧围绕在均值附近,波动平缓(如 A 班成绩);
- 标准差大:数据点离散发散在两端,波动剧烈(如 B 班成绩)。
手算演练:均值、离差与标准差计算
已知小样本数据集为 [2, 4, 6]:
-
第一步(计算均值 ):
-
第二步(计算各数据点的偏差及其平方):
- 数据点 2 的偏差平方:;
- 数据点 4 的偏差平方:;
- 数据点 6 的偏差平方:。
-
第三步(计算方差 ):
-
第四步(计算标准差 ):
5. 正态分布 (Normal Distribution):钟形曲线
正态分布(又称高斯分布 Gaussian Distribution)是自然界和数据科学中最常见、最重要的一种概率分布。
身高分布、考试成绩、测量误差、甚至人的鞋码,都服从正态分布。
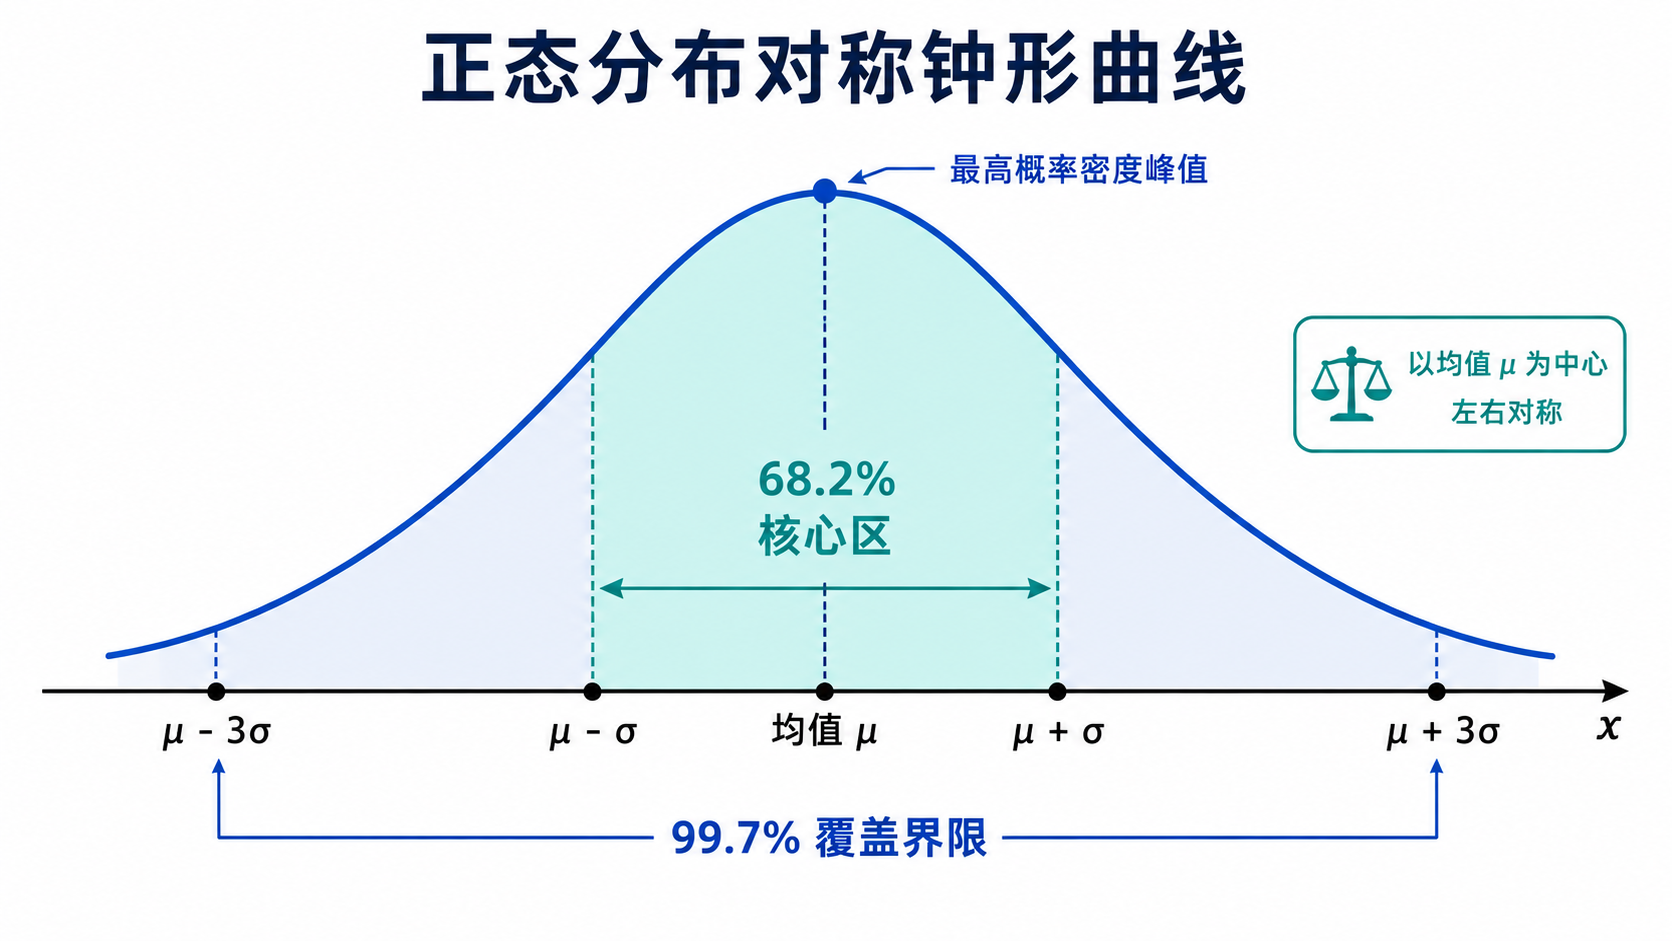 点击放大查看图:正态分布3σ钟形曲线经验法则
5.1 正态分布的 2 大参数
- 均值 :决定了钟形曲线在横轴上的中心峰值位置;
- 标准差 :决定了钟形曲线的高矮胖瘦:
- 越小:曲线越高耸尖锐(数据极度集中在均值附近);
- 越大:曲线越矮胖平缓(数据分布较为分散)。
5.2 3 经验法则 (68-95-99.7 Rule)
对于标准的正态分布:
中心极限定理 (CLT) 实验室
总体分布到样本均值正态收敛演练
每次抽样的样本量 5
N=1 (原始数据形态)N≥30 (满足大样本 CLT)
0.01.02.0 (均值)3.04.0
积累均值抽样数: 0
均值抽样统计特征
样本均值 0.0000
标准误 0.0000
CLT 现象观察要点:
1. 当 时,直方图反映的是倾斜的原始总体分布形态;2. 随着 增大至 30,直方图瞬间自动重构为**完美的对称正态钟形**!且标准误 显著缩小!
- 约 68.2% 的数据落在距离均值 1 个标准差区间内 ;
- 约 95.4% 的数据落在距离均值 2 个标准差区间内 ;
- 约 99.7% 的数据落在距离均值 3 个标准差区间内 (超出 3 个标准差的数据通常被视为极小概率的异常值)。
6. 从实数到区间:Sigmoid 函数
在分类任务中(如判断一封邮件是否为垃圾邮件),模型最终经过线性计算可能得到一个抽象的得分 或 。
如何将这个范围在 之间的实数得分,转化为在 之间直观的“概率值”?
这就需要用到 Sigmoid 激活函数。
6.1 Sigmoid 函数公式与 S 型曲线
Mermaid 流程示意图
矢量响应视图
手算演练:Sigmoid 得分到概率的映射推演
对于 Sigmoid 公式 ,验证三个经典得分 :
-
当得分 时(模棱两可):
-
当得分 时(强倾向于正例): 已知 ,代入得:
-
当得分 时(强倾向于负例): 已知 ,代入得:
Sigmoid 概率映射直觉
- 当模型得分 时:(概率为 50%,处于模棱两可的决策边界);
- 当模型得分 且越大时: 迅速向上弯曲并无线趋近于 (概率接近 100%);
- 当模型得分 且越小时: 迅速向下弯曲并无线趋近于 (概率接近 0%)。
7. 动手实战:计算数据集方差与 Sigmoid 概率
请在下方的代码块中,点击 “运行代码”,体验使用 Python 计算统计指标与概率映射:
数据统计指标与 Sigmoid 概率计算实战
import numpy as np
# 1. 计算班级学生成绩的集中与离散指标
scores = np.array([75, 82, 90, 85, 60, 95, 80, 78])
mean_val = np.mean(scores) # 均值
median_val = np.median(scores) # 中位数
std_val = np.std(scores) # 标准差
var_val = np.var(scores) # 方差
print(f"成绩均值 Mean: {mean_val:.2f}")
print(f"成绩中位数 Median: {median_val:.2f}")
print(f"成绩标准差 Std: {std_val:.2f}")
print(f"成绩方差 Var: {var_val:.2f}")
# 2. 手写 Sigmoid 函数将模型输出得分转化为概率
def sigmoid(z):
return 1.0 / (1.0 + np.exp(-z))
# 模拟 3 位患者的逻辑回归预测得分 z
model_scores = np.array([2.5, 0.0, -3.1])
probabilities = sigmoid(model_scores)
print("\n模型原始得分 z:", model_scores)
print(" Sigmoid 映射后的患病概率 P:", np.round(probabilities, 4))
8. 常见错误排查 (Troubleshooting)
| 错误现象 / 异常类型 | 常见原因 | 标准排查与处理方式 |
|---|---|---|
| 算出的均值与大部分数据的实际感受相差悬殊 | 数据集中存在极端异常值(如少数极大或极小值拉抬了均值) | 在存在异常值时,使用 np.median() (中位数) 替代 np.mean() 来描述集中趋势 |
运行 Sigmoid 函数时报 RuntimeWarning: overflow encountered in exp | 传入的得分 绝对值过大(如 ),导致 数值溢出 | 使用 np.clip(z, -500, 500) 对得分进行数值截断保护 |
| 不同特征数值范围相差悬殊导致模型训练缓慢 | 未进行特征标准化,不同特征的均值与标准差不在同一数量级 | 在训练前使用 Z-score 标准化: 将特征缩放到均值为 0、标准差为 1 的分布 |
9. 本节检查清单 (Checklist)
- 我理解均值 (Mean) 代表数据的中心水平,中位数 (Median) 对极端异常值更具鲁棒性;
- 我能理解方差 与标准差 衡量数据偏离均值离散程度的直觉;
- 我能说出正态分布对称“钟形曲线”的特征,以及均值 (位置)与标准差 (高矮胖瘦)的作用;
- 我理解 Sigmoid 函数 将任意实数连续压缩映射为 概率值的物理意义。
10. 课后互动自测
03. 概率统计直觉:均值、方差与概率 课后互动自测
共 4 道精选测试题 · 答题进度已自动保存
已完成:0 / 4
1 / 4
单选题
在统计一个公司所有员工的薪资水平时,如果公司 CEO 的年薪高达 5 亿元(远超普通员工),为了反映绝大多数普通员工的真实薪资水平,应该优先参考哪个指标?
1 / 4
11. 下一步
恭喜你完成了 阶段 0:编程、数据与数学基础 (Foundations) 的全部学习!
你已经成功建立起了 Python 编程功底、科学计算技能以及极简的数学直觉。
下一步我们将正式跨入 01. 线性回归与正则化 的学习!
12. 参考资料
- Khan Academy: 概率与统计基础课程 —— 可视化概率统计入门。
- StatQuest with Josh Starmer: 正态分布与 Sigmoid 直觉 —— 全网最接地气的统计与 ML 动画讲解。
本页目录
1. 问题导入
2. 学习目标
3. 概率的基本语言:事件、条件与更新
3.1 样本空间、事件与概率
3.2 条件概率与独立性
3.3 贝叶斯公式:用条件概率反向计算
3.4 随机变量与期望
4. 数据的集中与离散:均值、中位数与方差
4.1 集中趋势:均值 vs 中位数
4.2 离散程度:方差与标准差
5. 正态分布 (Normal Distribution):钟形曲线
5.1 正态分布的 2 大参数
5.2 3$\sigma$ 经验法则 (68-95-99.7 Rule)
6. 从实数到区间:Sigmoid 函数
6.1 Sigmoid 函数公式与 S 型曲线
7. 动手实战:计算数据集方差与 Sigmoid 概率
8. 常见错误排查 (Troubleshooting)
9. 本节检查清单 (Checklist)
10. 课后互动自测
11. 下一步
12. 参考资料
核心概念术语表
数据的算术平均数,代表数据集的中点趋势与中心位置
数据偏离均值距离平方的平均值,衡量数据的离散波动程度
自然界最常见的对称钟形概率分布曲线,均值决定中心,标准差决定胖瘦
把任意实数连续压缩映射到 (0, 1) 区间输出为二分类概率的激活函数